So liest du ein Spektrogramm
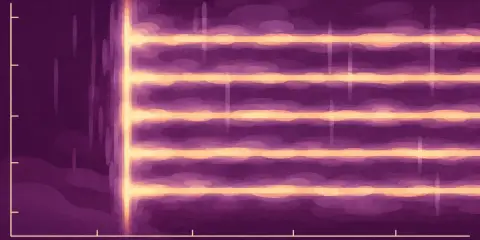
Ein Spektrogramm zeigt die Zeit von links nach rechts, die Frequenz von unten nach oben und den Pegel als Helligkeit. Ein Spektrogramm gut zu lesen läuft auf drei Entscheidungen hinaus: wie lang das Stück Ton ist, das jede Spalte analysiert, wie die Frequenzachse eingeteilt ist und welche Pegel die Farben abdecken. Die Zahlen unten gelten für eine Aufnahme mit 48 kHz, der Rate, die die meisten Dateien und Mikrofone nutzen.
Spalten, Zeilen und Helligkeit
Jede Spalte ist ein kurzes Fenster Ton, in seine Frequenzen zerlegt, jede Zeile ist ein Frequenzband, und die Helligkeit zeigt, wie laut dieses Band in diesem Fenster war. Standardmäßig hat ein Fenster 2.048 Samples: Bei 48 kHz sind das 42,7 ms Ton, und seine Frequenzzeilen liegen 23,4 Hz auseinander.
Fenster überlappen sich um 75 %, sodass alle 10,7 ms eine neue Spalte beginnt. Mehr Überlappung ergibt ein glatteres Bild mit mehr Spalten, aber keine feineren Details: Was eine Spalte zeigen kann, bestimmt die Länge des Fensters.
Fenstergröße: scharf in der Zeit oder scharf in der Tonhöhe
Ein Fenster mit N Samples bei einer Abtastrate f_s dauert N/f_s Sekunden, und seine Frequenzzeilen liegen f_s/N Hertz auseinander. Halbiert man das eine, verdoppelt sich das andere, keine Einstellung ist also in beidem scharf. 512 Samples dauern 10,7 ms mit Zeilen 93,8 Hz auseinander: Klicks, Trommelschläge und Konsonanten bleiben knackig, aber nahe Töne verschmelzen. 8.192 Samples dauern 171 ms mit Zeilen 5,86 Hz auseinander: Nahe Töne und die Obertöne eines Brummens trennen sich, aber kurze Geräusche verschmieren seitlich.
Die Form des Fensters zählt weniger. Hann, die Voreinstellung, passt für die meisten Töne; Blackman–Harris hat viel schwächere Nebenkeulen, sodass ein leiser Ton neben einem lauten sichtbar bleibt, auf Kosten etwas breiterer Spitzen.
Fensterlänge und Zeilenabstand nach FFT-Größe
| FFT-Größe | 44,1 kHz | 48 kHz | 96 kHz |
|---|---|---|---|
| 256 | 5,8 ms · 172 Hz | 5,33 ms · 188 Hz | 2,67 ms · 375 Hz |
| 512 | 11,6 ms · 86,1 Hz | 10,7 ms · 93,8 Hz | 5,33 ms · 188 Hz |
| 1.024 | 23,2 ms · 43,1 Hz | 21,3 ms · 46,9 Hz | 10,7 ms · 93,8 Hz |
| 2.048 | 46,4 ms · 21,5 Hz | 42,7 ms · 23,4 Hz | 21,3 ms · 46,9 Hz |
| 4.096 | 92,9 ms · 10,8 Hz | 85,3 ms · 11,7 Hz | 42,7 ms · 23,4 Hz |
| 8.192 | 186 ms · 5,38 Hz | 171 ms · 5,86 Hz | 85,3 ms · 11,7 Hz |
| 16.384 | 372 ms · 2,69 Hz | 341 ms · 2,93 Hz | 171 ms · 5,86 Hz |
Jede Zelle: wie lange das Fenster dauert · wie weit seine Frequenzzeilen auseinanderliegen. Eine FFT-Größe öffnet das Tool mit diesem Fenster.
Sprache, Musik und kurze Geräusche
Sprache wird üblicherweise in Fenstern von etwa 20 ms analysiert: kurz genug, um einen Laut zu erfassen, lang genug, um die Obertöne der Stimme zu trennen. Bei 48 kHz ist die nächste FFT-Größe 1.024 Samples (21,3 ms). Ein kürzeres Fenster mit 256 Samples (5,33 ms, Zeilen 188 Hz auseinander) verwischt die Obertöne zu breiten Bändern, sodass stattdessen die Formanten hervortreten, die Resonanzen, die jeden Vokal ausmachen.
Gehaltene Musik und gleichmäßiges Brummen lesen sich am besten mit längeren Fenstern, die Töne und Obertöne trennen. Schneller Vogelgesang, Klopfen und andere rasche Ereignisse brauchen kürzere; hat ein Geräusch beides, sieh es dir zweimal mit zwei Größen an.
Helligkeit ist der Pegel in dBFS
Pegel sind in Dezibel relativ zur Vollaussteuerung angegeben: 0 dBFS ist eine Sinuswelle mit dem größten Pegel, den die Datei fassen kann, alles andere ist negativ. Alle 20 dB weniger sind ein Zehntel der Amplitude, 6 dB weniger etwa die Hälfte. Eine 16-Bit-Datei umfasst von der Vollaussteuerung bis zu ihrem Rundungsrauschen etwa 96,3 dB, leise Details liegen also weit unter den lauten.
Die Farben decken nur einen Ausschnitt dieses Bereichs ab. „Automatische Pegel“ passt den Ausschnitt an das an, was im Bild ist; ein höher gesetzter dunkelster Pegel verbirgt den Rauschteppich, ein niedriger macht leise Geräusche sichtbar, zusammen mit mehr Rauschen.
Was ein Pegel in dBFS bedeutet
| Pegel | Amplitude | Leistung |
|---|---|---|
| 0 dBFS | 100 % | 100 % |
| −6 dBFS | 50,1 % | 25,1 % |
| −12 dBFS | 25,1 % | 6,31 % |
| −20 dBFS | 10 % | 1 % |
| −40 dBFS | 1 % | 0,01 % |
| −60 dBFS | 0,1 % | 0,0001 % |
Als Anteil einer vollausgesteuerten Sinuswelle: Amplitude 10^(L/20), Leistung 10^(L/10) bei einem Pegel von L dB.
Lineare, logarithmische und Mel-Frequenzachsen
Eine lineare Achse gibt jedem Hertz dieselbe Höhe, sodass die hohen Frequenzen den größten Teil des Bildes einnehmen. Eine logarithmische Achse gibt jeder Oktave dieselbe Höhe, wie die Tasten eines Klaviers, was zu Musik und den meisten natürlichen Geräuschen passt. Die Mel-Achse folgt dem wahrgenommenen Abstand der Tonhöhen: mel = 2595·log10(1 + f/700), bei tiefen Frequenzen fast linear und höher logarithmisch. 1000 Hz sind 1.000 mel, 4000 Hz sind 2.146 mel und 8000 Hz 2.840 mel.
Frequenz auf jeder Höhe der Achse
| Höhe | Linear | Logarithmisch | Mel |
|---|---|---|---|
| 10 % | 2,02 kHz | 39,9 Hz | 307 Hz |
| 25 % | 5,02 kHz | 112 Hz | 967 Hz |
| 50 % | 10 kHz | 632 Hz | 3,16 kHz |
| 75 % | 15 kHz | 3,56 kHz | 8,24 kHz |
| 90 % | 18 kHz | 10 kHz | 14,1 kHz |
Für eine Achse von 20 Hz bis 20 kHz; die Höhe wird von unten gemessen, als Anteil der Achse.
Formen, auf die du achten kannst
Eine waagerechte Linie ist ein gleichbleibender Ton: ein Pfeifen, ein Lüfter oder Netzbrummen bei 50 oder 60 Hz und seinen Vielfachen. Ein Stapel gleichmäßig verteilter Linien ist ein Klang mit Obertönen, etwa eine Stimme, ein Instrument oder ein Motor, und der Abstand ist seine Tonhöhe. Eine senkrechte Linie ist ein Klick, ein Klopfen oder jedes plötzliche Geräusch, und ein breiter grauer Schleier ist Rauschen: Zischen, Wind, Regen oder Verkehr.
Gebogene Linien zeigen eine sich ändernde Tonhöhe. Ein Ton, der beim Vorbeifahren fällt, am schnellsten im Moment der größten Nähe, ist die Doppler-Verschiebung einer bewegten Quelle, die das Tool nachzeichnen und in eine Geschwindigkeit umrechnen kann.
Der obere Bildrand: die halbe Abtastrate
Eine Aufnahme enthält bei oder über der Hälfte ihrer Abtastrate nichts: 24 kHz bei 48 kHz, 22,05 kHz bei einer CD. Ein leeres Band über einer scharfen, glatten Kante weiter unten bedeutet meist, dass die Datei komprimiert wurde oder das Mikrofon die Höhen weggefiltert hat, nicht dass der Ton dort nichts hatte.
Höchste Frequenz nach Abtastrate
| Abtastrate | Höchste Frequenz | Standardfenster |
|---|---|---|
| 8 kHz | 4 kHz | 256 ms |
| 16 kHz | 8 kHz | 128 ms |
| 22,05 kHz | 11,025 kHz | 92,9 ms |
| 44,1 kHz | 22,05 kHz | 46,4 ms |
| 48 kHz | 24 kHz | 42,7 ms |
| 96 kHz | 48 kHz | 21,3 ms |
| 192 kHz | 96 kHz | 10,7 ms |
| 384 kHz | 192 kHz | 5,33 ms |
Das Standardfenster hat 2.048 Samples; bei einer höheren Rate dauert es weniger lang.
Quellen
- J. O. Smith, Spectral Audio Signal Processing: Classic Spectrograms (CCRMA, Stanford)
- J. O. Smith, Spectral Audio Signal Processing: Spectrogram of Speech (CCRMA, Stanford)
- J. O. Smith, Spectral Audio Signal Processing: Spectrum Analysis Windows (CCRMA, Stanford)
- J. O. Smith, Mathematics of the DFT: Sampling Theorem (CCRMA, Stanford)
Häufige Fragen
Warum sieht mein Spektrogramm verschwommen aus?
Seitliche Unschärfe heißt, das Fenster ist für den Ton zu lang: Wähle eine kleinere FFT-Größe. Unschärfe nach oben und unten heißt, es ist zu kurz, um die Frequenzen zu trennen: Wähle eine größere. Auch Hineinzoomen in Zeit oder Frequenz verteilt die Details auf mehr Bildschirm.
Warum ist in meiner MP3 über etwa 16 kHz nichts?
Verlustbehaftete Encoder schneiden oft das obere Band ab, um Platz zu sparen, und das Spektrogramm zeigt den Schnitt als glatte Decke. Das ursprüngliche WAV oder FLAC behält diese Frequenzen bis zur Hälfte seiner Abtastrate.
Ist ein Spektrogramm dasselbe wie ein Spektrum?
Nein. Ein Spektrum ist ein Satz Pegel nach Frequenz für ein Stück Ton; ein Spektrogramm sind viele davon nebeneinander, eines pro Moment, sodass du sehen kannst, wie sich die Frequenzen mit der Zeit ändern.